阅读 HIL-SERL 有感
了解到这篇 paper 的起点是 8 月份在 WRC 和星海图后训练工程师李城钰的对话,让我了解到了 DAgger, RL, HIL-SERL, RECAP...
 当时我就觉得很有意思,因为那个 demo 展现了机器人是怎么自己学会去 correct itself,以及学会一些非常细节的人类操作,我觉得非常震惊
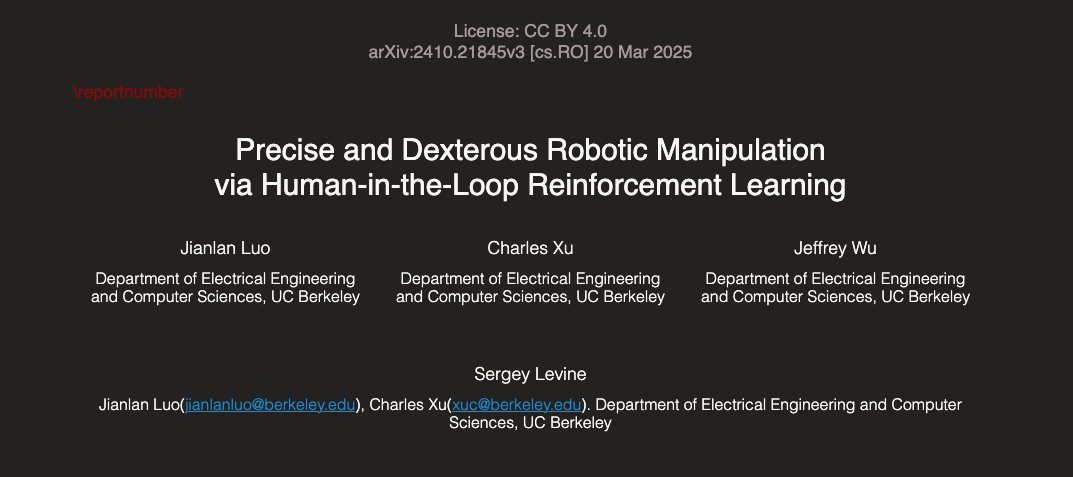
这篇 paper 也算是人机交互 & 强化学习的一个非常著名的 frontier reading, 最近才慢慢把它咀嚼完,并且开始复现。以下是我阅读这篇 paper 的一些感受:
- 人类纠正能够给机器人 & 强化学习大大缩小探索的空间,大幅度提升效率和训练成功率
- 这篇 paper 取了一个 balance - 又能够通过人类示范和纠正来让机器人更高效学习,但又不至于像传统的模拟学习策略那般被限制(于人类的表现)
- 强化学习也不是万灵药 - 如果没有人类数据辅助,只用 RL from scratch 的成功率为零
- 承上:强化学习不应该被浪费(其实配置强化学习不简单),应该被拿来学习那些真正难啃的硬骨头。如果在物理配置上、环境配置上能够简化的,那就要从那里下功夫。不是所有事情都需要靠「技术」来解决... 条条大路通罗马,能抓老鼠的猫就是好猫!
- 强化学习的成功与否 / 有效取决于几个变量:任务的 long-horizon nature(有多少步骤)、样本复杂度()达到某个效果需要多少轮的学习)、state space 的可能性以及每个状态下有多少动作可以选
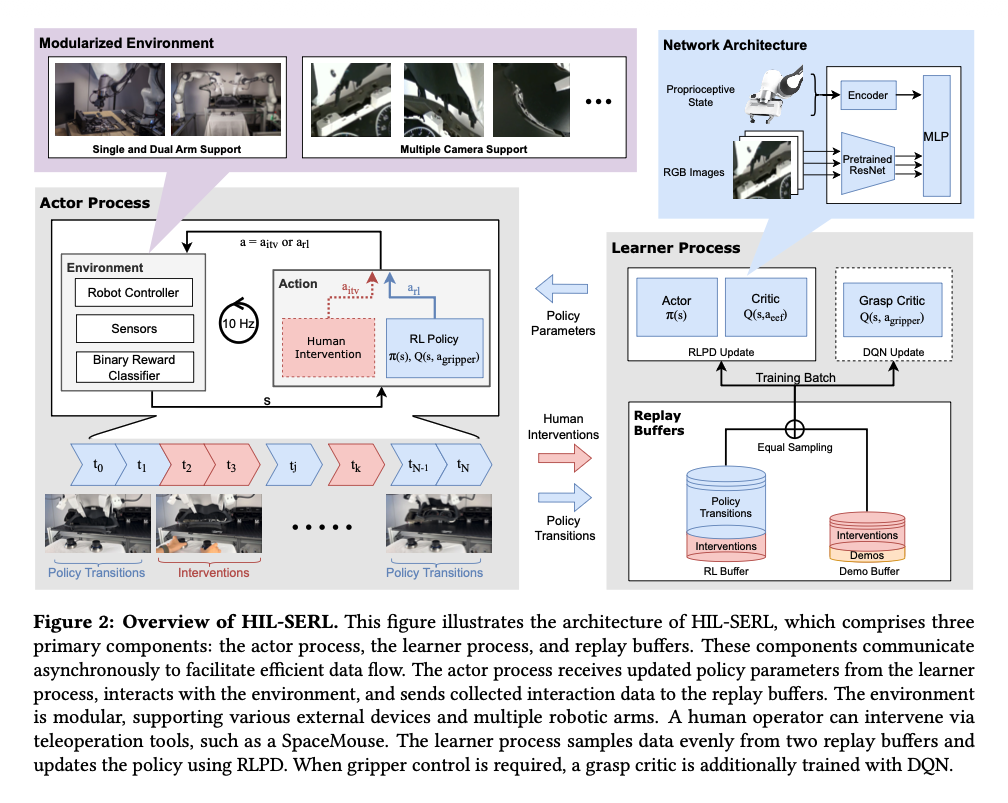
- 全面性地了解了强化学习的系统设计,包括:
- Actor Process(执行策略并把机器人输出的数据存储到 buffer 的程序), learner process(通过从 replay buffer 里面提取数据并更新策略以及 critic 的程序,critic 是那个给当下动作打分的角色), replay buffer 则分为 demo buffer & RL buffer
- .... 省略很多技术细节 .....
- 更加深刻地体会到,当 sparse reward 的情况下时,策略如何去学习?其实是通过长期期望的这个步骤来学。当下的这个动作能够到底能够带来多少长期的价值?它一定是能够层层影响,影响到 reward = 1 的那一步,那就可以做一个回传的乘法,拿到当下动作的价值。这也让我深刻体会到了 long task horizon 给学习带来的难度
- 和 HG-DAgger 比起来的就是 - DAgger 会让机器人学到人类的上限,而不是去从成功和失败案例倒推出来最有效的方式,毕竟每个人类的工作熟练度参差不齐,你会 overfit the humans